로컬 LLM 과잉 추론 줄이기, 12GB 65토큰
Qwen3.8-27B의 과잉 추론을 줄인 Swift·ThinkingCap 비교, 12GB VRAM에서 65 tok/s를 냈다는 Strata 엔진, llama.cpp 프롬프트 캐시 설정, 클로드 코드 v2.1.282 수정 내역을 실무 관점에서 정리했습니다.
- 발행
- 수정
- 없음
- 읽는 시간
- 약 4분
- 근거 자료
- 9건 공식 4 · 커뮤니티 5
이 글로 알 수 있는 것
- 에이전트가 느릴 때 생각 토큰, 프롬프트 캐시, 추론 엔진 중 어디를 먼저 손댈지 판단하는 기준
- Swift·ThinkingCap 같은 저추론 변형이 실제로 무엇을 줄이고 무엇을 못 줄이는지
- 클로드 코드 v2.1.282에서 세션 이어쓰기 관련으로 고쳐진 내용과 확인 방법
목차 · 소제목 6개
오늘 고른 네 가지
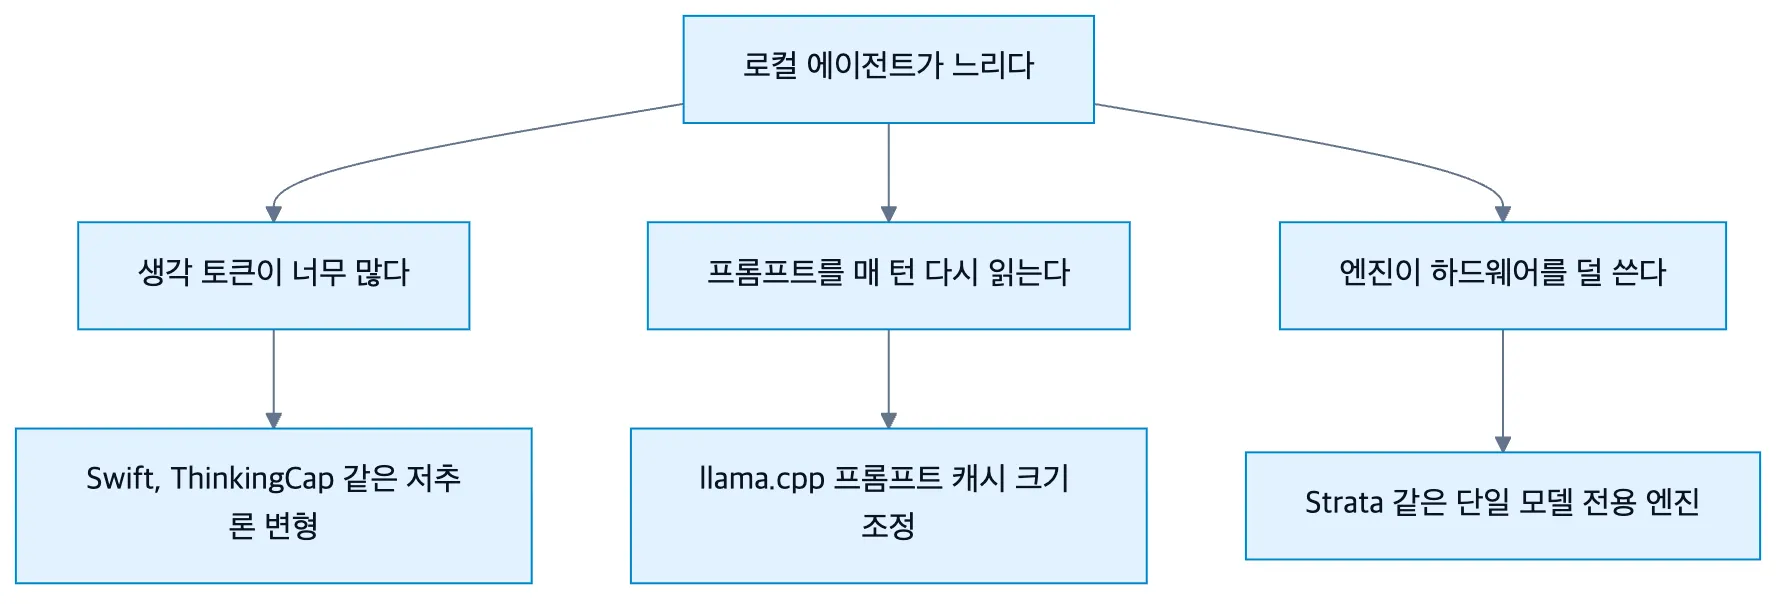
안녕하세요, 거노쌤입니다. 오늘 올라온 소식을 보니 공교롭게도 주제가 하나로 모입니다. “로컬 에이전트가 왜 이렇게 느린가”입니다. 원인은 크게 셋인데, 오늘 소식이 각각 하나씩 건드립니다.
1. 생각을 덜 하는 27B, 실제로 빨라졌나
Qwen3.8-27B는 추론 루프에 잘 빠진다는 말이 많았습니다. 이걸 줄인 변형이 두 개 나왔고, r/LocalLLaMA에 세 모델을 같은 Aider 평가로 돌린 비교커뮤니티가 올라왔습니다. 작성자는 모델당 2회, 전부 Q8_0, llama.cpp 기준이라고 밝혔습니다.
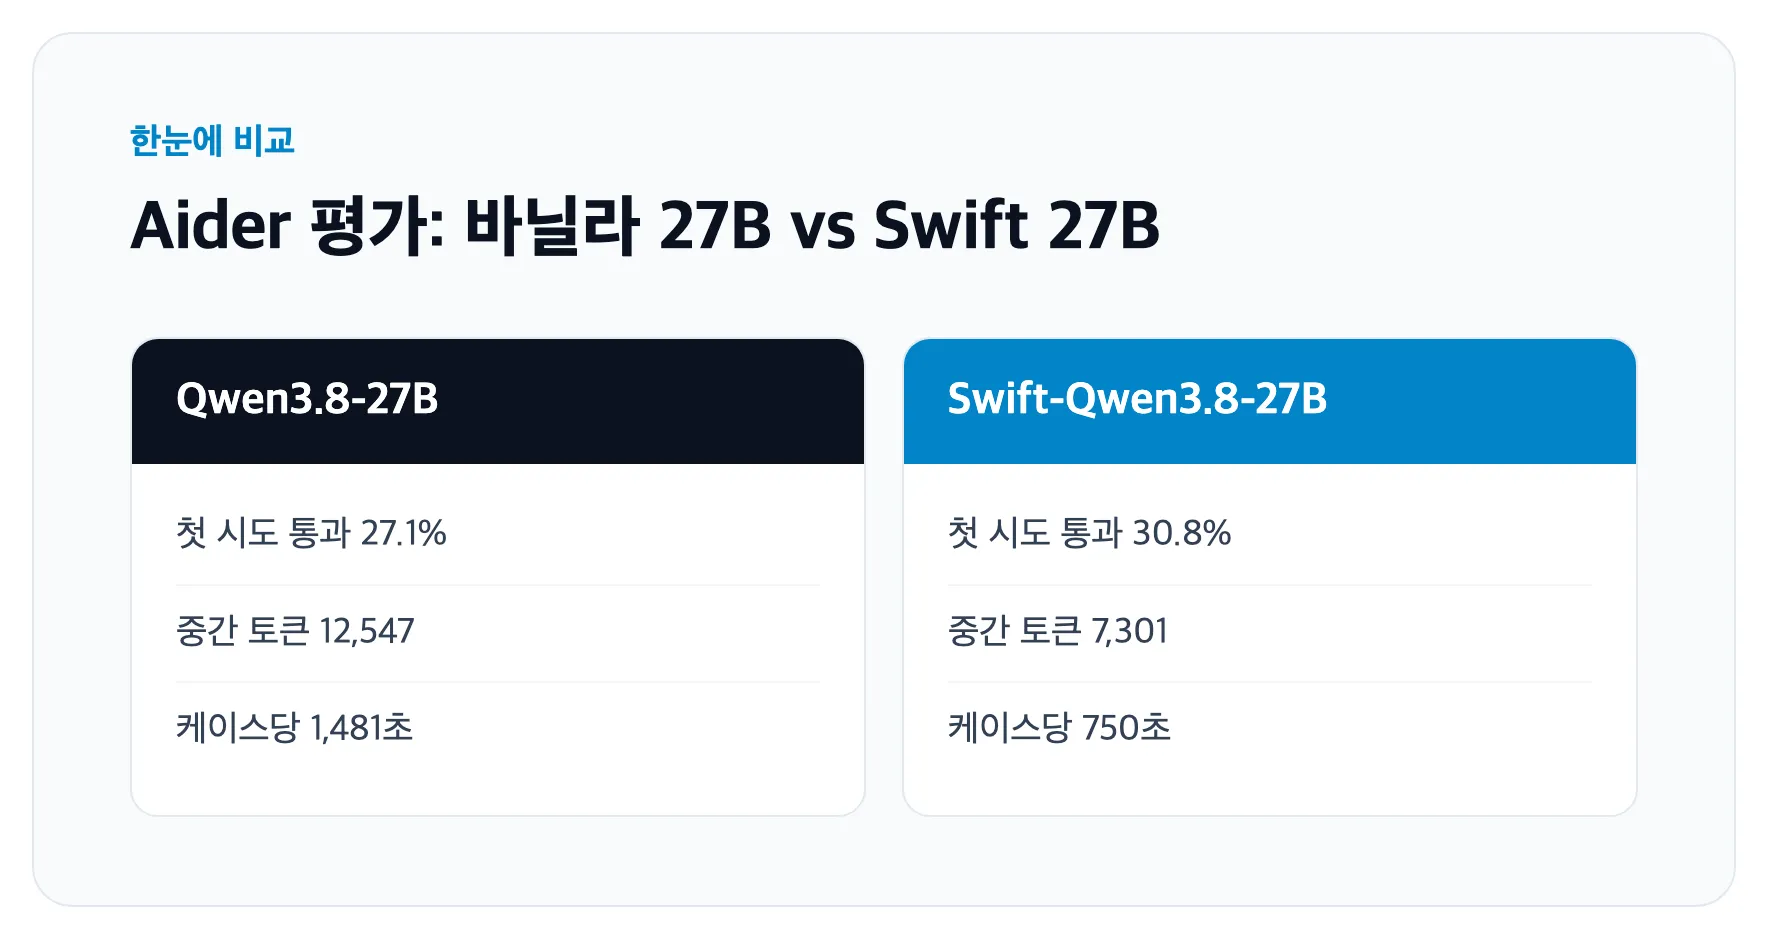
은 절반, 시간도 절반인데 첫 시도 정답률은 밀리지 않습니다. 다만 재시도까지 포함한 통과율은 바닐라 77.6%, Swift 75.7%로 Swift가 조금 낮고, 잘 만들어진 diff 비율도 99.1% 대 98.1%로 근소하게 뒤집니다. 즉 “빠르지만 형식은 살짝 덜 얌전하다”가 정직한 요약입니다. ThinkingCap은 바닐라와 점수가 완전히 같게 나왔는데, 작성자 본인도 우연으로 보라고 적어 뒀습니다.
제작사 쪽 발표도 같은 날 있었습니다. UkisAI가 레딧에 올린 Swift 계열 공개 글커뮤니티에 따르면 Swift1.5 27B가 사고 토큰을 58.5% 줄이면서 점수는 0.35%p 높았고, Flash Next는 사고 토큰 63.4% 감소에 1.8배 속도입니다. 제3자 검증이 없는 자체 벤치마크라는 점은 감안하세요.
업무로 옮기면 이렇습니다. 회의록 요약이나 분류처럼 정답이 짧은 일에는 저추론 변형이 그대로 이득입니다. 반대로 코드 수정처럼 출력 형식이 깨지면 안 되는 일은, 재시도 비용까지 계산해 보고 고르는 게 맞습니다.
2. 12GB 카드에서 65 tok/s를 냈다는 전용 엔진
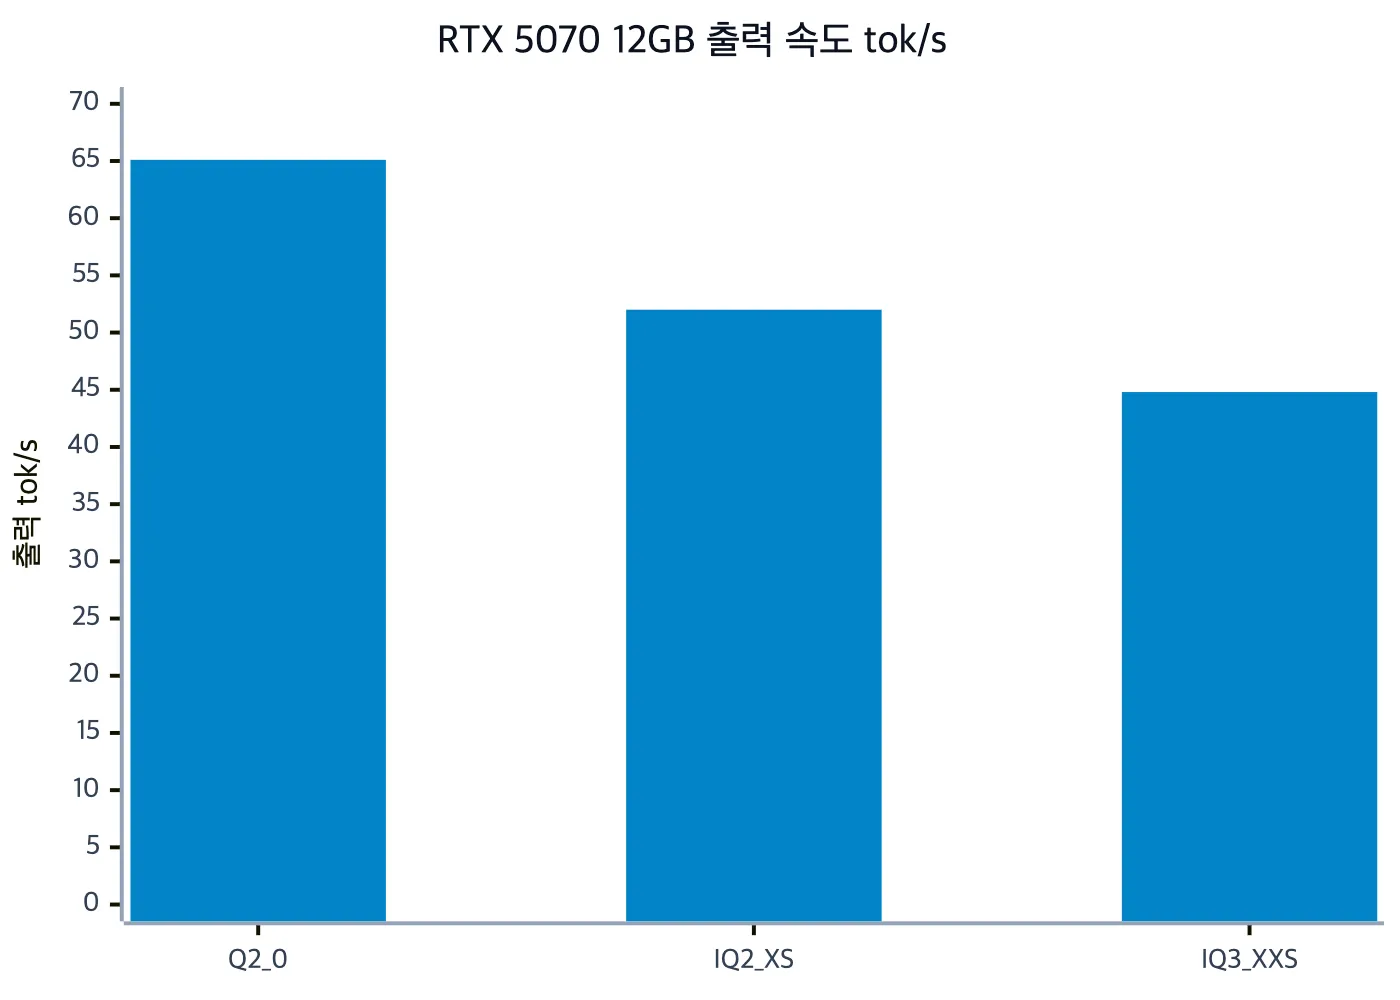
RTX 5070 12GB에 DDR5 64GB를 쓰는 분이 Qwen3.8-Flash-Next 하나만 겨냥한 추론 엔진 Strata공식를 공개했습니다. 게시자가 올린 표(128K 기준)를 보면 같은 IQ3_XXS (모델을 가볍게 압축한 것)에서 예전 15 tok/s가 44.8 tok/s로 올랐고, 가장 가벼운 Q2_0은 65.1 tok/s였습니다. 제목의 65 tok/s는 Q2_0 기준입니다. 모델은 ISTA-DASLab의 GSQ-RCO GGUF공식를 씁니다.
주의할 점은 메모리입니다. 모델 카드공식 기준으로 메모리에 늘 올려 둬야 하는 부분만 Q2_0이 37.6GB, IQ3_XXS가 47.0GB이고, 여기에 KV 캐시 여유분이 더 필요합니다. 내려받는 전체 크기는 각각 66.4GB, 75.8GB입니다. VRAM 12GB만 보고 덤비면 안 되고 본체 램이 넉넉해야 합니다. 게시자는 현재 CUDA만 최적화되어 있다고 밝혔습니다.
낮은 양자화가 정말 쓸 만한지는 또 다른 문제입니다. 다른 분이 올린 축소판 비교커뮤니티에서는 Flash-Next IQ4_XS가 MMLU-Pro 83.8%, 27B FP8이 75.0%였습니다. 다만 본인이 MMLU는 80문항만 썼다고 밝혔으니 참고용입니다.
3. llama.cpp 프롬프트 캐시, 기본값으로 두지 마세요
작지만 오늘 가장 바로 써먹을 수 있는 건 이겁니다. llama.cpp 서버의 프롬프트 캐시 크기 옵션 -cram은 공식 설명공식 기준 기본값이 8192MiB입니다. 레딧 PSA커뮤니티 작성자는 컨텍스트가 아주 길어지면 이 크기로는 모자라 매 턴 전체 컨텍스트를 다시 처리하게 된다고 짚었습니다. 작성자는 27B를 262K 컨텍스트로 돌릴 때 20480으로 올려 쓴다고 했고, VRAM은 안 늘고 시스템 램만 더 쓴다고 합니다. 에이전트로 같은 저장소를 오래 붙잡고 있는 분이라면 한 줄 바꿔 보고 체감 차이를 재 보세요.
4. 클로드 코드 v2.1.282, 이어쓰기 관련 수정
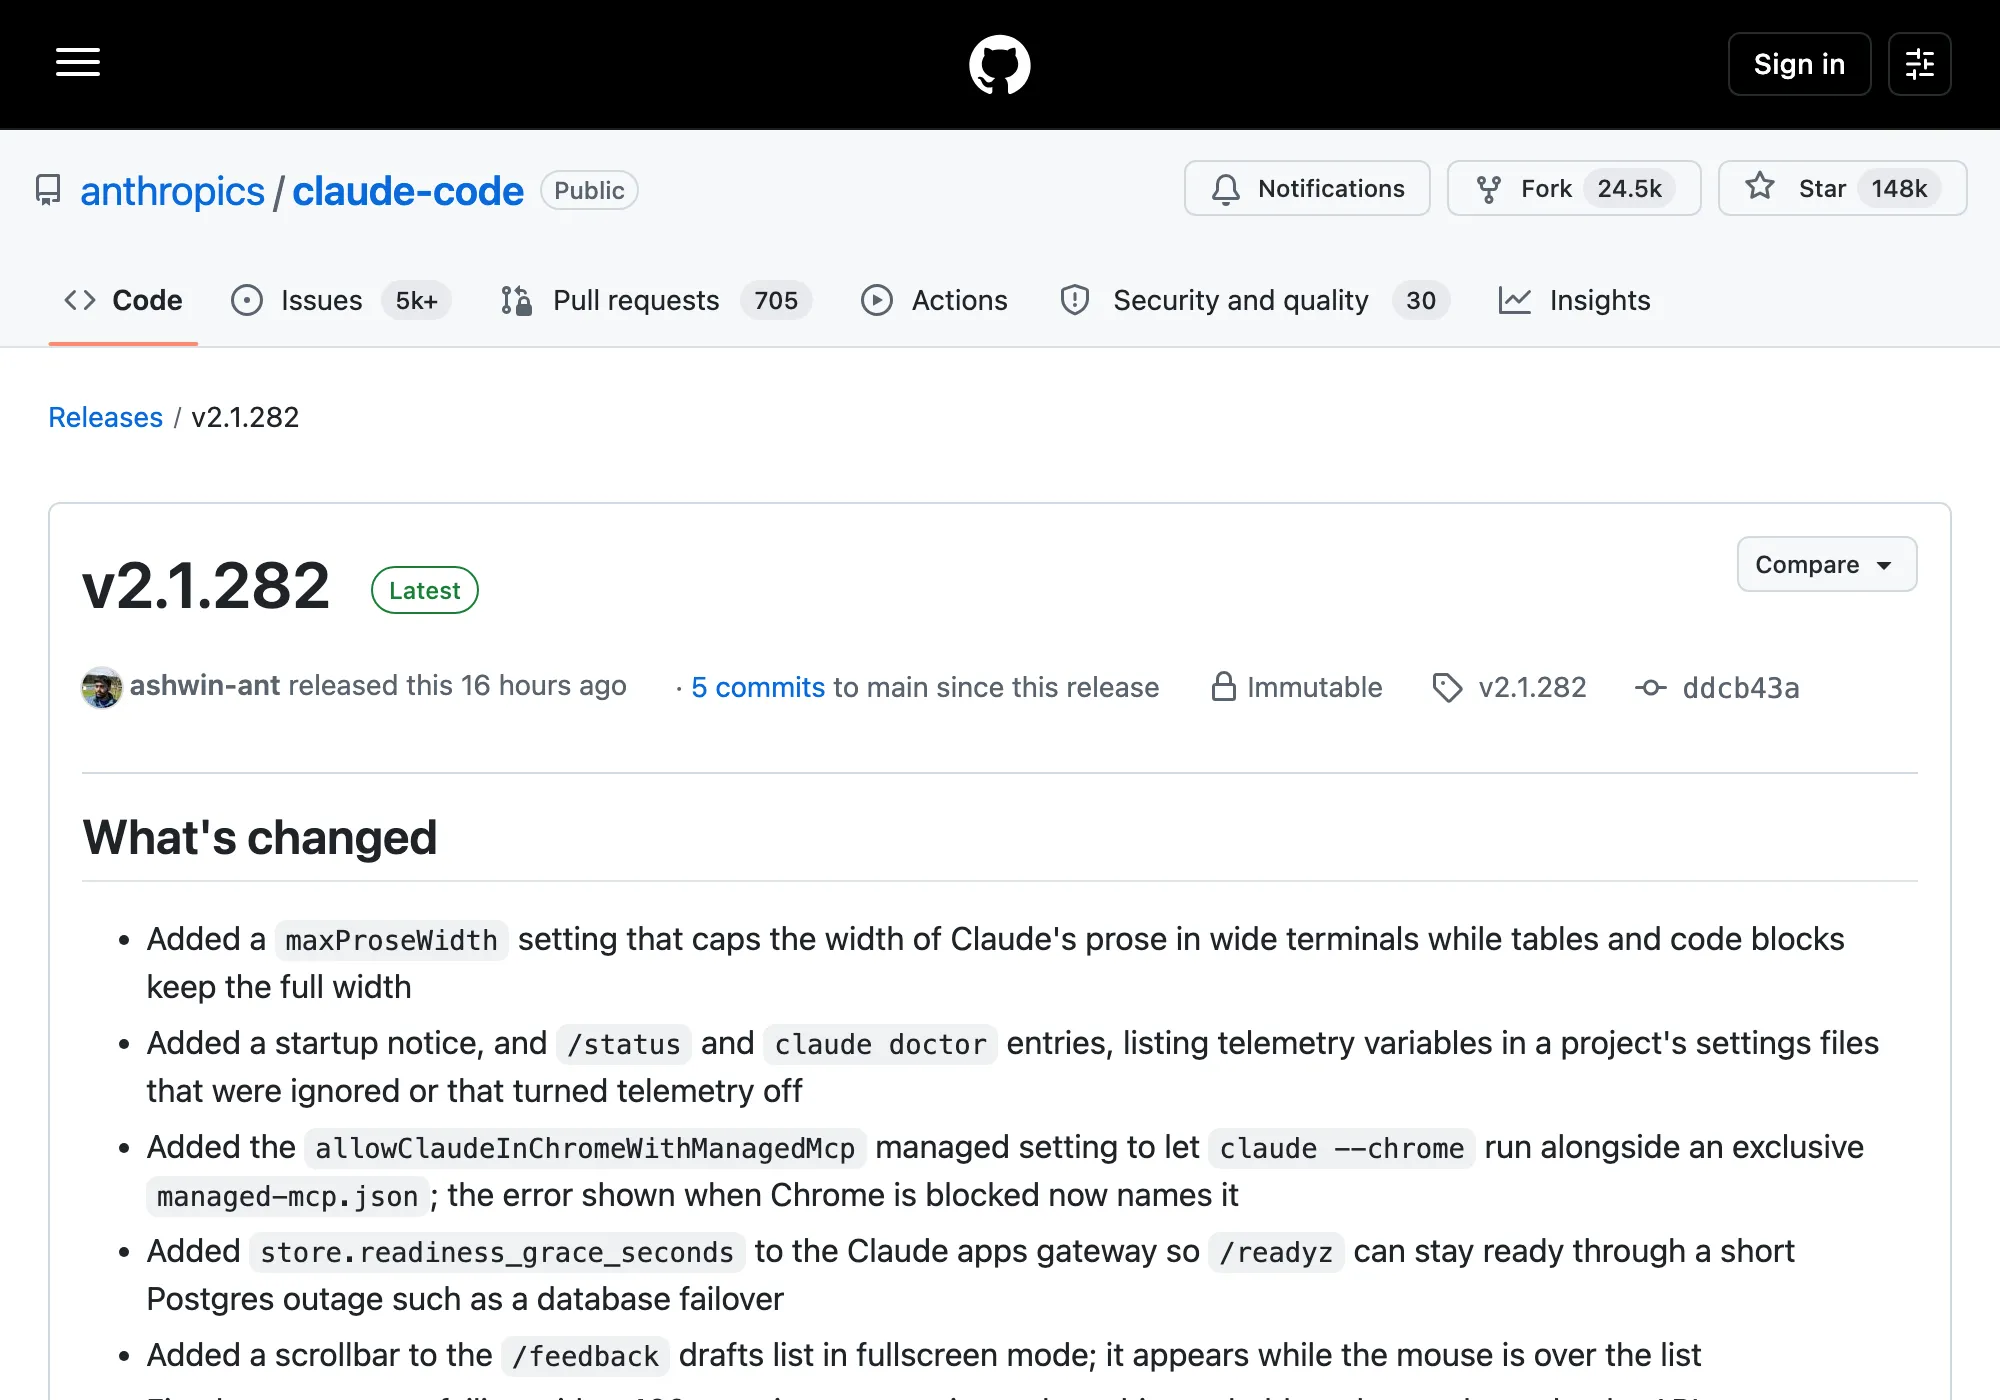
v2.1.282 릴리스 노트공식에서 눈에 띈 건 세 가지입니다. 첫째, --continue나 --resume으로 세션을 이어갈 때 이전 메시지가 변형된 채 다시 전송돼 앞선 추론이 버려지던 문제를 더 잡았습니다. 둘째, 작업 중에 /model, /rename 같은 슬래시 명령을 쓰면 앞의 확장 사고가 날아가던 것도 고쳤습니다. 셋째, API가 복호화할 수 없는 웹 검색 결과가 대화 기록에 있으면 모든 요청이 400으로 실패하던 문제가 수정됐습니다. 긴 세션을 끊었다 이어 쓰는 습관이 있다면 업데이트 값이 있습니다.
넓은 터미널에서 문장 폭을 제한하는 maxProseWidth 설정도 들어왔습니다. 표와 코드 블록은 원래 폭을 유지합니다. 27인치 모니터에 전체 화면으로 쓰는 분에게는 읽기가 한결 편해집니다.
오늘 할 일
- llama.cpp로 에이전트를 돌린다면
-cram값을 올려 보고 두 번째 턴 응답 시작까지 걸리는 시간을 비교해 보세요. - 요약·분류처럼 형식이 단순한 작업 하나를 골라 저추론 변형으로 바꿔 돌려 보고, 토큰 수와 결과 품질을 같이 기록하세요.
- 클로드 코드를 쓰면 v2.1.282로 올리고, 이어쓰기 세션에서 400 에러나 사고 유실이 재발하는지 확인하세요.
오늘 인용한 벤치마크는 대부분 개인이 자기 장비에서 돌린 값이라 재현은 각자 몫입니다. 숫자보다는 “어느 축을 손볼 차례인가”를 고르는 데 쓰시면 좋겠습니다.
참고한 자료 · 9건
- 공식 · 4
- anthropics/claude-code v2.1.282 릴리스 노트github.com
- llama.cpp 서버 옵션 설명 (-cram 기본값)github.com
- Niko1221/Strata 추론 엔진 저장소github.com
- ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUFhuggingface.co
- 커뮤니티 · 5 — 소식을 찾은 곳. 사실 확인은 공식 자료로
- ThinkingCap 3.8-27B vs. Swift 3.8-27B vs. Qwen 3.8-27B Benchmarksreddit.com
- UkisAI Swift Series / 27B, Flash Next and Bonsai 2 + GSQ-RCOreddit.com
- Qwen3.8-Flash-Next on 12GB VRAM - 65 tokens per secondreddit.com
- PSA: llama.cpp -cram should be increased for agentic workflowsreddit.com
- Did anyone do a full bench of e.g. Qwen Flash Next IQ4 and Qwen 27b FP8?reddit.com
수정 이력
이어서 읽기
이번 주 해외에서 새로 나온 것 가운데 일에 쓸 만한 것만 골라, 원문 링크와 함께 보내 드립니다.
팀에 이런 자동화를 들이고 싶다면 강의·도입 문의로 연락 주세요.